robots.txt orienta o rastreamento; noindex trata da inclusão no índice. Para o Google reconhecer uma regra noindex presente na página, precisa conseguir acessar essa resposta. Bloquear o rastreamento da mesma URL pode impedir a leitura da instrução, sem garantir que o endereço desapareça dos resultados.
O guia de SEO para organizar e melhorar o site reúne as frentes da revisão. Aqui, vamos delimitar um conflito entre regras e preparar sua conferência. O objetivo é conversar com quem mantém o ambiente, distinguindo intenção, configuração atual e estado conhecido pelo buscador.
Comece pela finalidade da página
Escreva o que a página deve permitir. Um artigo público que precisa ser encontrado, uma orientação pública após um formulário e um documento restrito têm finalidades diferentes. Antes de escolher uma regra, confirme quem precisa acessar o conteúdo e se há informação que exige proteção.
A introdução do Google ao robots.txt explica que o arquivo administra o acesso de rastreadores e tem limites: uma URL bloqueada pode ser conhecida por links e ainda aparecer na busca. O arquivo também não é um mecanismo de segurança para conteúdo privado.
Se a necessidade for restringir quem pode ler um documento, encaminhe a definição do controle de acesso adequado. Não transforme “não quero na busca” e “somente pessoas autorizadas podem abrir” em um único requisito. No exemplo deste artigo, o conteúdo é público e sem dados pessoais por premissa.
Confira se o rastreador consegue ler a regra de indexação
Na documentação do Google sobre noindex, a instrução pode ser emitida por metatag ou cabeçalho HTTP. O Google não aceita noindex como regra escrita dentro do robots.txt. Quando a URL está bloqueada para rastreamento, a instrução presente na resposta não fica disponível para leitura pelo rastreador.
| Pergunta | O que investigar | Conclusão a evitar |
|---|---|---|
| O conteúdo deve ser público? | Finalidade e controle de acesso definidos para a página. | Ausência na busca como prova de privacidade. |
| O Googlebot pode rastrear a URL? | Regra pertinente de robots.txt e acesso efetivo à resposta. | Abrir no navegador como confirmação do acesso do rastreador. |
| Qual regra de indexação é emitida? | Metatag ou cabeçalho efetivamente retornado. | Uma opção marcada no painel como prova da saída publicada. |
| O que o Google conhece dessa página? | Dados da URL na propriedade pertinente e data da informação. | Configuração atual como confirmação imediata do estado no índice. |
Não mude regras em massa para resolver uma única URL. Registre o endereço e o comportamento esperado, localize o componente responsável e combine o escopo da revisão. O mesmo site pode ter grupos de páginas com necessidades distintas.
Exemplo fictício: a página tem noindex, mas o caminho está bloqueado
Exemplo fictício: uma empresa mantém uma página pública de orientação após o envio de um formulário, no caminho inventado /confirmacao-exemplo/. A página não contém dados pessoais. A equipe quer que ela continue acessível ao visitante, mas não deseja sua inclusão na Pesquisa Google.
Por premissa do cenário, a resposta HTML contém noindex e uma regra aplicável do robots.txt bloqueia o Googlebot nesse caminho. Os trechos abaixo representam o conflito para discussão; não correspondem a arquivos de um site real e não foram aplicados ao ambiente.
Trechos fictícios que precisam ser analisados em conjunto
Regra aplicável no robots.txt do cenário:
User-agent: Googlebot
Disallow: /confirmacao-exemplo/

Trecho presente no head do HTML fictício:
<meta name="robots" content="noindex">
Finalidade fictícia
A página /confirmacao-exemplo/ é pública e sem dados pessoais. Deve continuar acessível ao visitante, mas a equipe não deseja sua inclusão na Pesquisa Google.
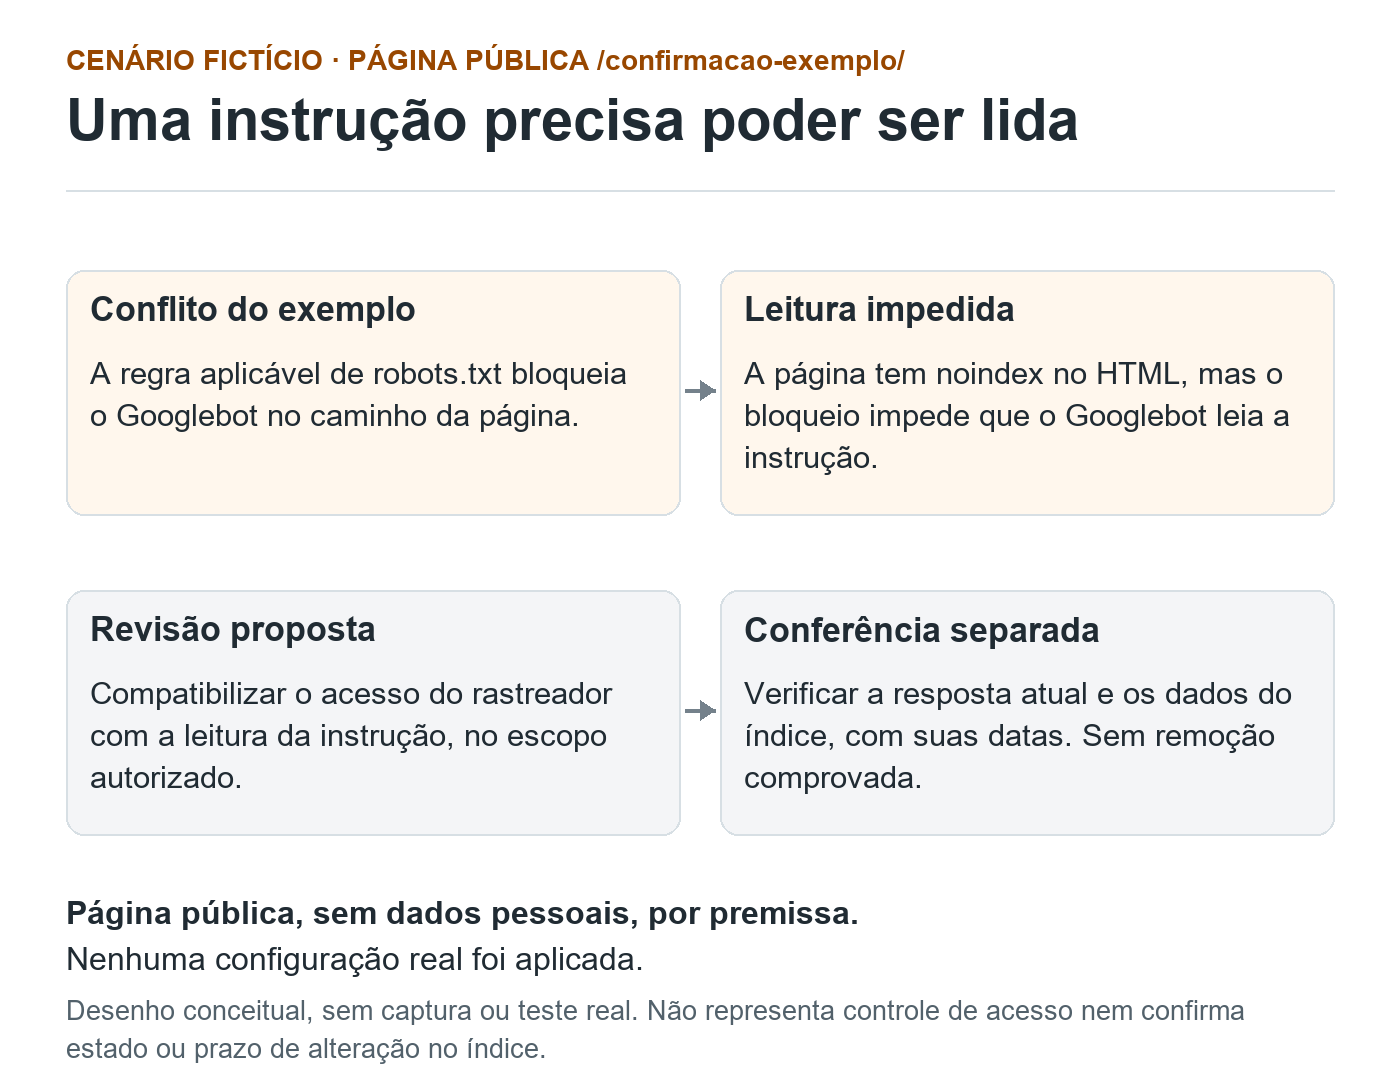
Conflito do exemplo
Uma regra aplicável de robots.txt bloqueia o Googlebot no caminho. O noindex está no HTML, mas não pode ser lido pelo rastreador bloqueado.
Revisão proposta
Compatibilizar o acesso do rastreador com a leitura da instrução desejada, no escopo autorizado. Não é liberação automática de áreas restritas.
Conferência e limite
Examinar separadamente a resposta atual e os dados do índice, com suas datas. Nenhuma configuração real aplicada, remoção ou prazo comprovados.
Descrição da figura
O desenho conceitual separa o conflito fictício e sua revisão proposta. Na primeira linha, uma regra aplicável de robots.txt bloqueia o Googlebot em /confirmacao-exemplo/, enquanto a página tem noindex no HTML; o bloqueio impede a leitura da instrução pelo rastreador. Na segunda linha, a proposta é compatibilizar o acesso com a leitura da instrução desejada no escopo autorizado. Depois seria necessário conferir separadamente a resposta atual e os dados do índice, com suas datas. A página é pública e sem dados pessoais por premissa. As setas relacionam o conflito e a conferência, não comprovam implementação. Nenhuma configuração real, teste ou remoção foram executados; não há estado ou prazo de mudança no índice comprovados.
O diagnóstico proposto é específico: a regra de rastreamento impede que o Googlebot leia a instrução presente no HTML desse caminho. Não há evidência, no exercício, de que a URL tenha sido removida da busca. Também não se conclui que o conteúdo precise virar privado, porque a finalidade declarada é pública.
A revisão a discutir com o responsável é tornar o acesso do rastreador compatível com a leitura da instrução desejada, preservando a finalidade da página. Antes de alterar qualquer regra, confirme dependências, origem da configuração e forma de retorno. A proposta do exemplo não é uma ordem para liberar áreas restritas ou mudar todo o arquivo robots.txt.
Separe a resposta atual dos dados conhecidos pelo Google
A ajuda da ferramenta de inspeção de URL do Search Console diferencia dados da versão indexada e teste da página atual. Ela apresenta informações de rastreamento e indexação, com limitações. Os dados indexados podem representar uma versão anterior à alteração, e o teste em tempo real não garante presença nos resultados.
Na rotina de conferência, registre quando a mudança foi aplicada e a data da informação consultada. Se uma regra foi ajustada hoje, um relatório sobre rastreamento anterior não prova que a nova versão já foi processada. A diferença de datas é uma pendência a acompanhar, não um motivo para alternar configurações sem diagnóstico.
No exemplo, seria possível conferir tecnicamente o acesso atual e a emissão da instrução após uma implementação autorizada. O estado da URL na Pesquisa exigiria outra evidência. Como não há site ou configuração reais no exercício, nenhuma dessas etapas foi executada nem existe prazo de remoção comprovado.
Peça uma correção com escopo e resultado verificáveis
Descreva o problema observado sem antecipar uma solução global: “precisamos revisar o conflito entre o bloqueio deste caminho e a instrução que a página pretende comunicar”. Inclua quem definiu a finalidade, quem pode alterar o componente e quais outros caminhos precisam ser preservados.
Depois da alteração autorizada, confira a saída efetiva. Um plugin, tema, servidor ou serviço intermediário pode participar da resposta. Se o comportamento continuar diferente do esperado, investigue a origem em vez de acrescentar instruções sobrepostas para tentar esconder o conflito.
Se a dúvida for escolher uma versão preferencial ou substituir um endereço, consulte o artigo sobre canonical e redirecionamento 301. São decisões próprias, que precisam corresponder à função das URLs. Não use uma exclusão de indexação para evitar essa análise.
Registro para revisar rastreamento e indexação
URL e finalidade da página:
Conteúdo público ou acesso restrito, conforme definição responsável:
Comportamento esperado para o visitante:
Objetivo para rastreamento e indexação:
Regra aplicável de robots.txt e origem:
Resposta atual, metatag e cabeçalhos pertinentes:
Componente responsável e dependências:
Diagnóstico e proposta delimitados:
Autorização, cópia recuperável e forma de retorno:
Implementação realizada e data, quando houver:
Teste da resposta atual e evidência:
Dados do índice consultados, propriedade e data da informação:
O que foi confirmado e o que continua pendente:
Responsável e próxima conferência:
Perguntas frequentes sobre robots.txt e noindex
Bloquear uma página no robots.txt garante que ela saia do Google?
Não. Uma URL bloqueada pode ser conhecida por outras referências. Defina a finalidade e investigue o método adequado, sem confundir bloqueio de rastreamento com exclusão confirmada do índice.
Posso colocar a regra noindex dentro do robots.txt?
O Google não suporta noindex escrito como regra do robots.txt. A documentação descreve a instrução por metatag ou cabeçalho HTTP, com acesso que permita ao rastreador lê-la.
Uma página com noindex fica protegida contra acesso de pessoas?
Noindex não define quem pode abrir o conteúdo. Se a necessidade for restringir a leitura, estabeleça o controle de acesso pertinente, de acordo com a finalidade e os responsáveis pelo ambiente.
Depois de mudar a configuração, posso considerar o índice atualizado?
Confira separadamente a resposta atual e os dados conhecidos pelo buscador, com suas datas. A alteração aplicada não comprova processamento imediato nem prazo fixo de mudança nos resultados.
Se sua equipe precisa organizar um diagnóstico por página, converse conosco sobre as prioridades de SEO. Podemos ajudar a delimitar objetivos e evidências. Implementação técnica, controles de acesso e acompanhamento precisam de responsabilidades e escopos definidos.
Citar este conteúdo
Maikon Richardson. robots.txt e noindex: diferencie rastreamento e indexação. MAIKON.biz, 26/10/2026. Disponível em: https://maikon.biz/robots-txt-noindex-rastreamento-indexacao/
Última alteração registrada no WordPress: .
Descrição da empresa no Google: como escrever e conferir
Imagem responsiva: como conferir o arquivo exibido no site
Canonical e redirecionamento 301: diferenças e conferência